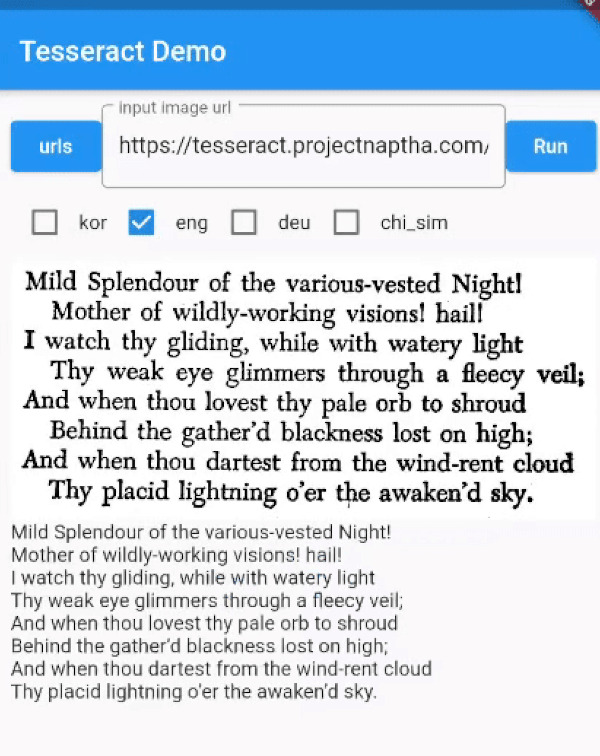
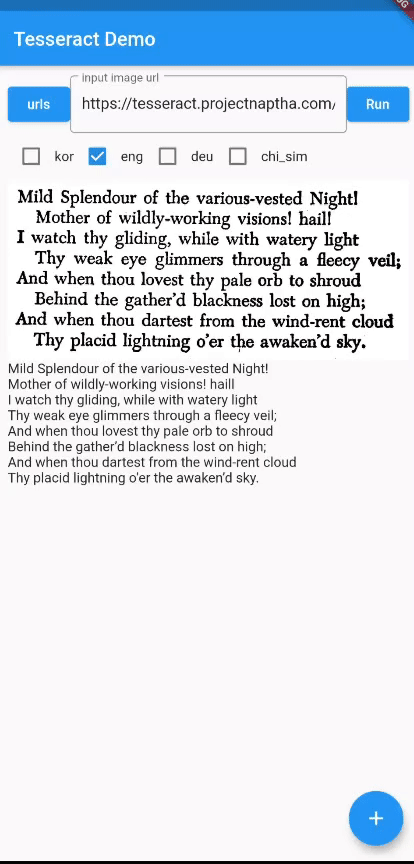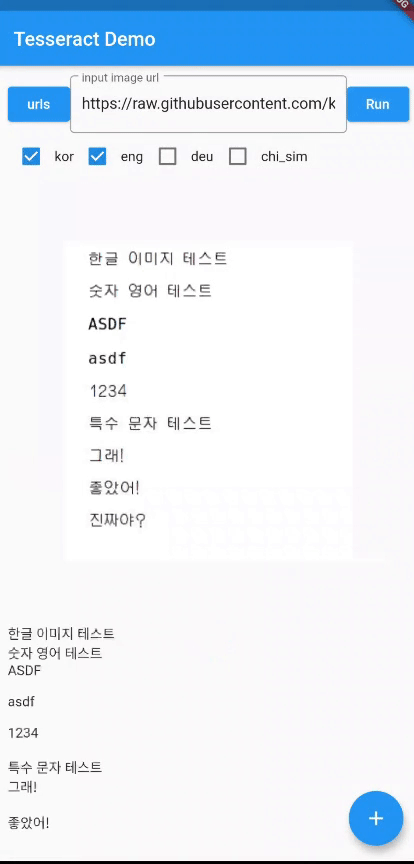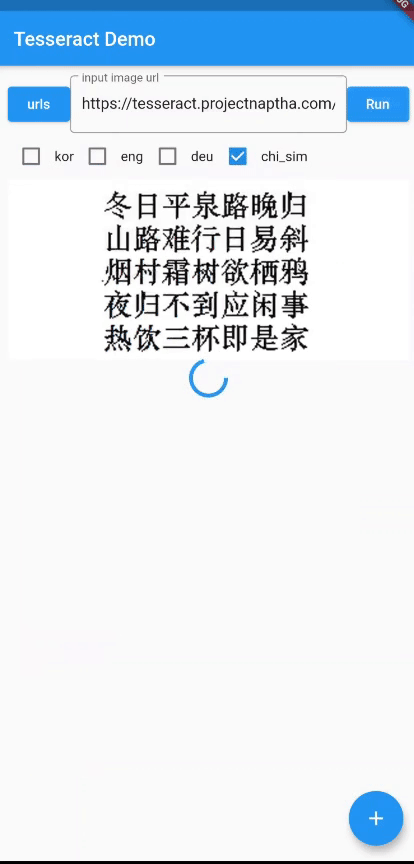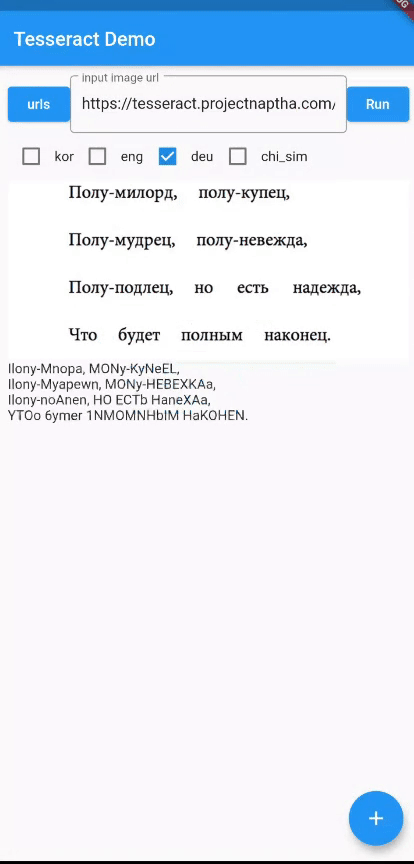
O Tesseract 4 adiciona um novo motor OCR baseado em rede neural (LSTM) focado na reconhecimento de linhas. Ele possui suporte a Unicode (UTF-8) e consegue reconhecer mais de 100 idiomas.
Orientação gerada a partir de informações públicas. Apenas para referência.
Flutter Tesseract OCR é um plugin Flutter que integra o avançado motor OCR baseado em rede neural (LSTM) do Tesseract 4, permitindo reconhecimento preciso de texto em imagens em mais de 100 idiomas. Ele suporta Unicode (UTF-8), tornando-o ideal para aplicativos multilíngues. O plugin funciona nas plataformas Android, iOS e Web, oferecendo aos desenvolvedores uma solução confiável para digitalização de documentos e extração de texto em aplicativos Flutter.
Casos de uso
Digitalização de documentos em aplicativos móveis
Extração de texto de imagens
Reconhecimento de texto multilíngue
Captura automática de dados de formulário
Funcionalidade de busca baseada em imagens
Principais recursos
motor OCR baseado em LSTM
Suporte para mais de 100 idiomas
Saída de texto Unicode (UTF-8)
Compatibilidade multiplataforma
Alta precisão na reconhecimento de linha
Indicado para
Aplicativos móveis que exigem OCR
Ferramentas de gerenciamento de documentos
Extração de texto independente de idioma
Projetos híbridos de web e móvel
Aplicativos com fluxos de trabalho de imagem para texto
Considerações
Requer pré-processamento de imagem para melhores resultados
O desempenho pode variar em dispositivos de baixa potência
Configuração adicional necessária para idiomas não padrão
Suporte offline limitado sem modelos embutidos
O tamanho do modelo afeta o tamanho do pacote do aplicativo
README original
Snapshot do README original do repositório-fonte vinculado. Consulte o repositório para o conteúdo mais recente.
Tesseract OCR for Flutter
Fork note (onestudi0/tesseract_ocr): This fork exists solely to fix android/build.gradle,
which still declares the defunct jcenter() repository — current Gradle rejects the jcenter()
DSL method outright, so upstream fails to build at all as of this writing. This fork replaces it
with mavenCentral(). No other changes. If upstream (khjde1207/tesseract_ocr) ever merges an
equivalent fix, switch back to the pub.dev release and drop the dependency_overrides pointing
here.
You must add trained data and trained data config file to your assets directory.
You can find additional language trained data files here Trained language files
add tessdata folder under assets folder, add tessdata_config.json file under assets folder:
//args support android / Web , i don't have a macString text = awaitFlutterTesseractOcr.extractText('/path/to/image', language: 'kor+eng',
args: {
"psm": "4",
"preserve_interword_spaces": "1",
});
You can leave language empty, it will default to `'eng'.