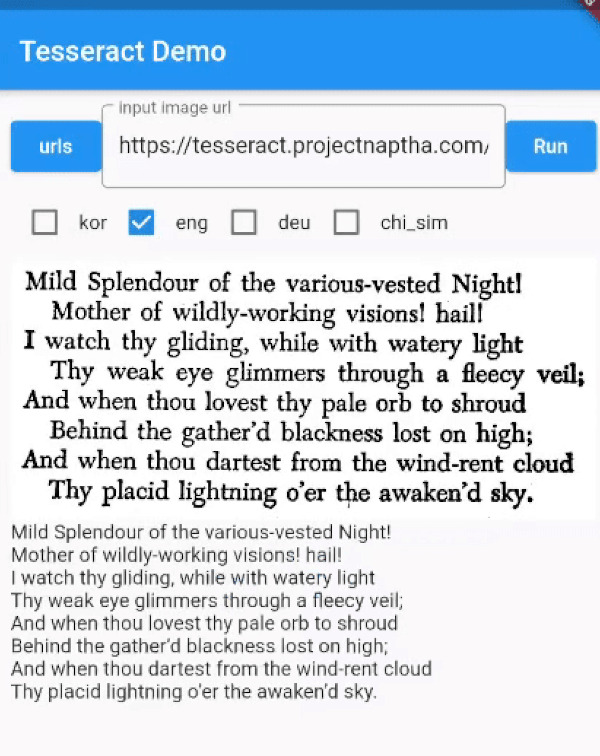
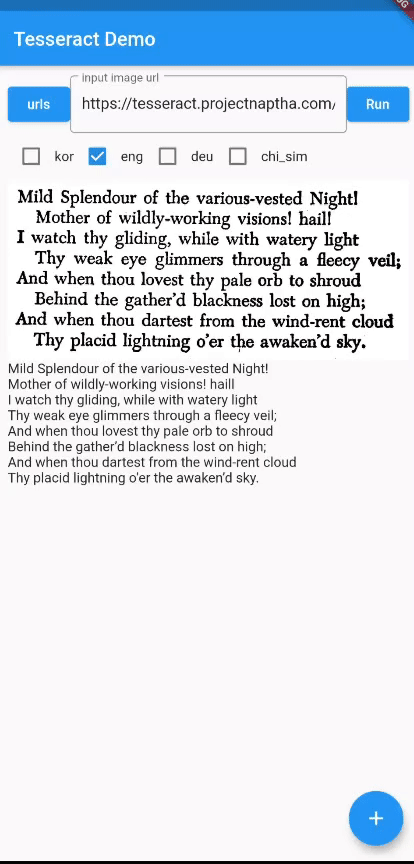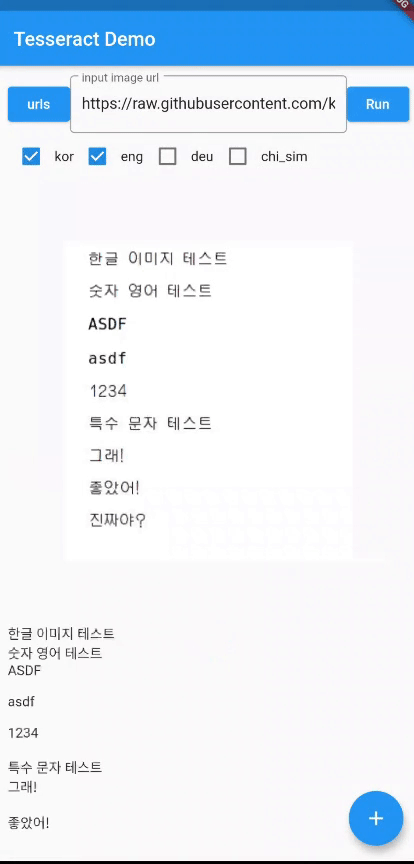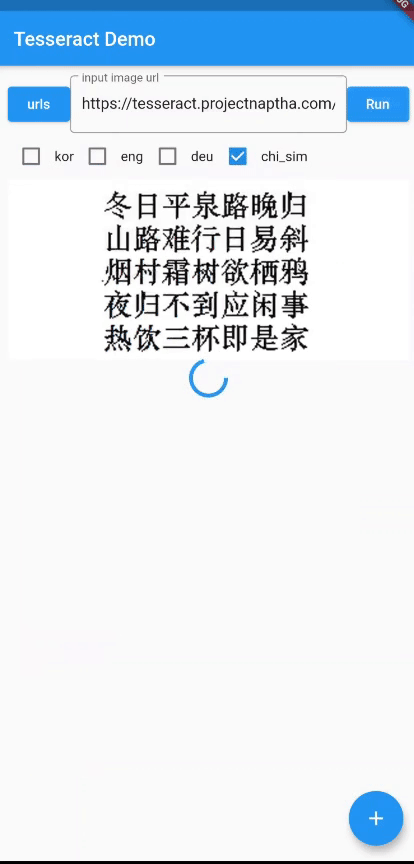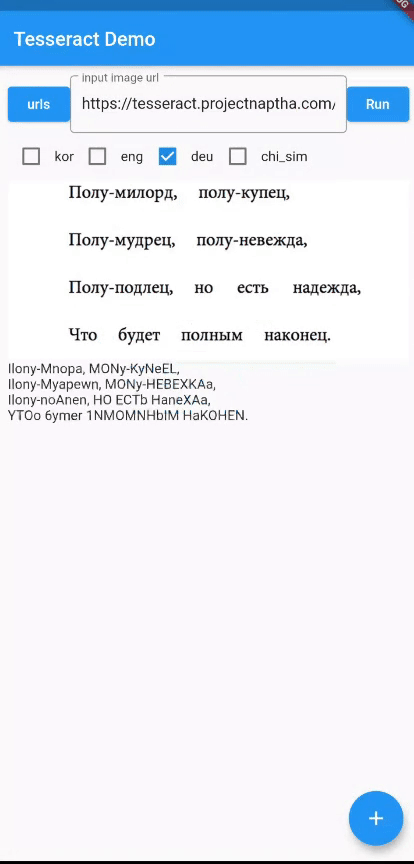
Flutter Tesseract OCR는 Tesseract 4의 고급 신경망(LSTM) 기반 OCR 엔진을 통합한 Flutter 플러그인으로, 100개 이상의 언어에서 이미지로부터 정확한 텍스트 인식이 가능합니다. 유니코드(UTF-8)를 지원하여 다국어 애플리케이션에 적합합니다. 이 플러그인은 Android, iOS, Web 플랫폼에서 작동하며, Flutter 앱 내에서 문서 스캔 및 텍스트 추출을 위한 개발자용 신뢰할 수 있는 솔루션을 제공합니다.
사용 사례
모바일 앱에서의 문서 스캔
이미지에서 텍스트 추출
다국어 텍스트 인식
자동 폼 데이터 캡처
이미지 기반 검색 기능
주요 기능
LSTM 기반 OCR 엔진
100개 이상의 언어 지원
유니코드 (UTF-8) 텍스트 출력
크로스 플랫폼 호환성
라인 수준 인식에서 높은 정확도
적합한 대상
OCR가 필요한 모바일 앱
문서 관리 도구
언어에 관계없는 텍스트 추출
웹 및 모바일 하이브리드 프로젝트
이미지에서 텍스트로의 워크플로를 갖춘 앱
고려 사항
최상의 결과를 얻으려면 이미지 전처리가 필요합니다
저사양 기기에서는 성능이 다를 수 있습니다
기본이 아닌 언어를 위한 추가 설정 필요
통합 모델 없이 제한된 오프라인 지원
모델 크기는 앱 번들 크기에 영향을 미칩니다
원본 README
연결된 소스 저장소의 README 원문 스냅샷입니다. 최신 내용은 저장소에서 확인하세요.
Tesseract OCR for Flutter
Fork note (onestudi0/tesseract_ocr): This fork exists solely to fix android/build.gradle,
which still declares the defunct jcenter() repository — current Gradle rejects the jcenter()
DSL method outright, so upstream fails to build at all as of this writing. This fork replaces it
with mavenCentral(). No other changes. If upstream (khjde1207/tesseract_ocr) ever merges an
equivalent fix, switch back to the pub.dev release and drop the dependency_overrides pointing
here.
You must add trained data and trained data config file to your assets directory.
You can find additional language trained data files here Trained language files
add tessdata folder under assets folder, add tessdata_config.json file under assets folder:
//args support android / Web , i don't have a macString text = awaitFlutterTesseractOcr.extractText('/path/to/image', language: 'kor+eng',
args: {
"psm": "4",
"preserve_interword_spaces": "1",
});
You can leave language empty, it will default to `'eng'.