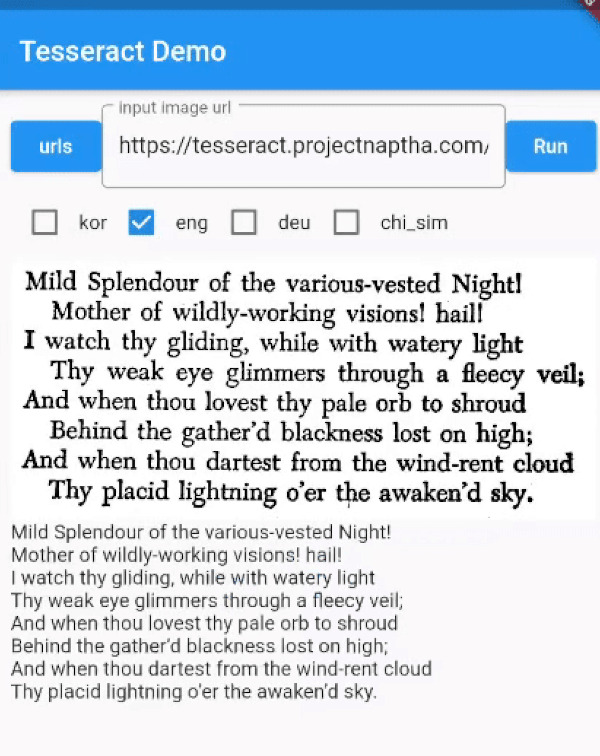
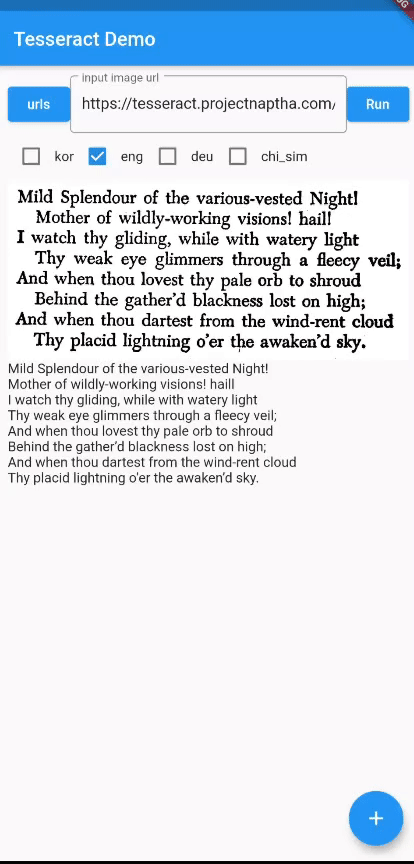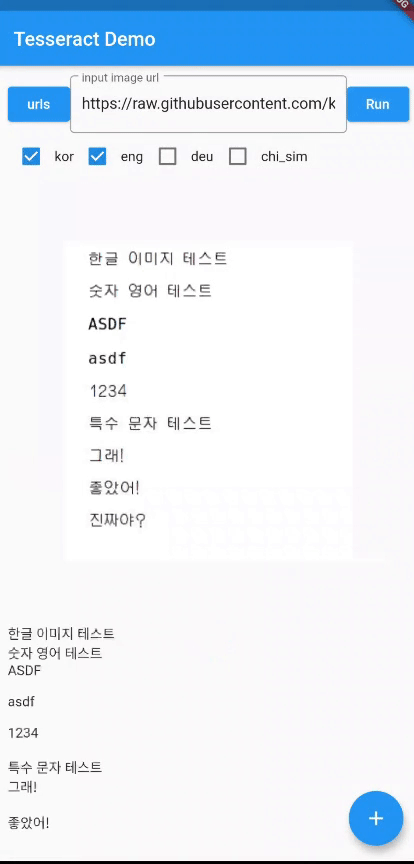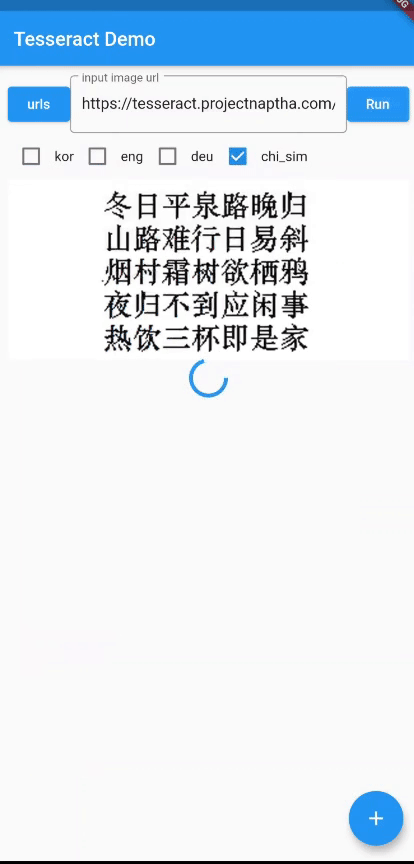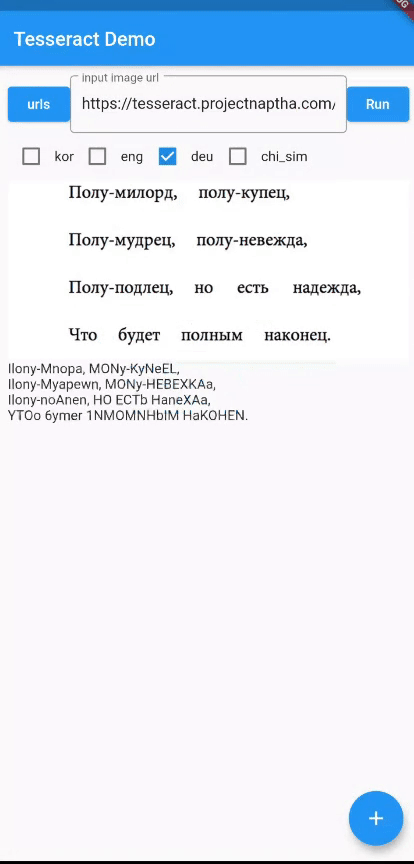
Tesseract 4 fügt eine neue, auf einem neuronalen Netzwerk (LSTM) basierende OCR-Engine hinzu, die sich auf die Zeilenerkennung konzentriert. Sie unterstützt Unicode (UTF-8) und kann mehr als 100 Sprachen erkennen.
Aus öffentlichen Paketdaten erstellte Orientierung.
Flutter Tesseract OCR ist ein Flutter-Plugin, das den fortschrittlichen neuronalen Netzwerk-(LSTM)-basierten OCR-Engine von Tesseract 4 integriert und somit eine genaue Texterkennung aus Bildern in über 100 Sprachen ermöglicht. Es unterstützt Unicode (UTF-8), was es ideal für mehrsprachige Anwendungen macht. Das Plugin funktioniert auf Android, iOS und Web-Plattformen und bietet Entwicklern eine zuverlässige Lösung für die Dokumentenscanning- und Textextraktion innerhalb von Flutter-Apps.
Anwendungsfälle
Dokumentenscanning in mobilen Apps
Textextraktion aus Bildern
Mehrsprachige Texterkennung
Automatisierte Formulardaten-Erfassung
Bildbasierte Suchfunktion
Hauptmerkmale
LSTM-basiertes OCR-Engine
Unterstützung für über 100 Sprachen
Unicode (UTF-8) Textausgabe
Plattformübergreifende Kompatibilität
Hohe Genauigkeit bei der Zeilen-Erkennung
Geeignet für
Mobile Apps, die OCR erfordern
Dokumentenverwaltungstools
sprachunabhängige Textextraktion
Web- und Mobile-Hybridprojekte
Apps mit Bild-zu-Text-Workflows
Hinweise
Bildvorverarbeitung für beste Ergebnisse erforderlich
Die Leistung kann sich auf Geräten mit geringer Leistung unterscheiden
Zusätzliche Einrichtung für nicht-standard Sprachen erforderlich
Eingeschränkter Offline-Support ohne eingebundene Modelle
Das Modellgröße beeinflusst die App-Bundle-Größe
Original-README
Originaler README-Schnappschuss aus dem verknüpften Quell-Repository. Aktuelle Inhalte finden Sie im Repository.
Tesseract OCR for Flutter
Fork note (onestudi0/tesseract_ocr): This fork exists solely to fix android/build.gradle,
which still declares the defunct jcenter() repository — current Gradle rejects the jcenter()
DSL method outright, so upstream fails to build at all as of this writing. This fork replaces it
with mavenCentral(). No other changes. If upstream (khjde1207/tesseract_ocr) ever merges an
equivalent fix, switch back to the pub.dev release and drop the dependency_overrides pointing
here.
You must add trained data and trained data config file to your assets directory.
You can find additional language trained data files here Trained language files
add tessdata folder under assets folder, add tessdata_config.json file under assets folder:
//args support android / Web , i don't have a macString text = awaitFlutterTesseractOcr.extractText('/path/to/image', language: 'kor+eng',
args: {
"psm": "4",
"preserve_interword_spaces": "1",
});
You can leave language empty, it will default to `'eng'.