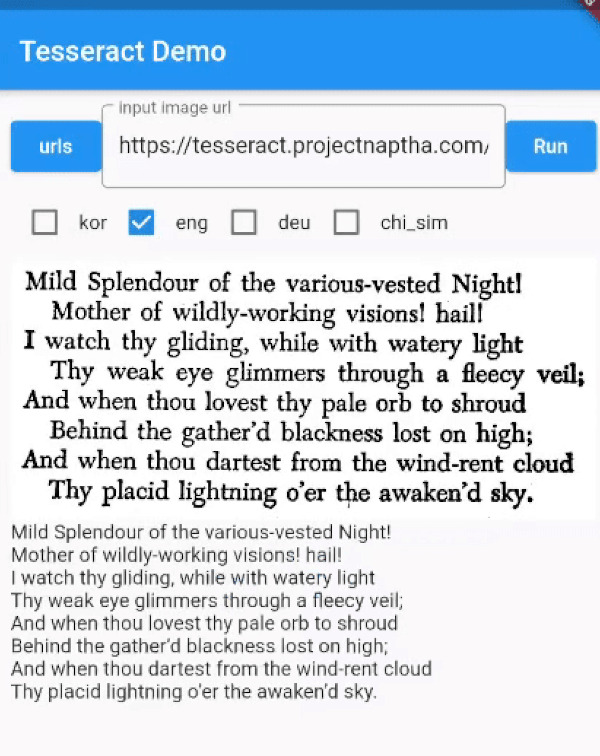
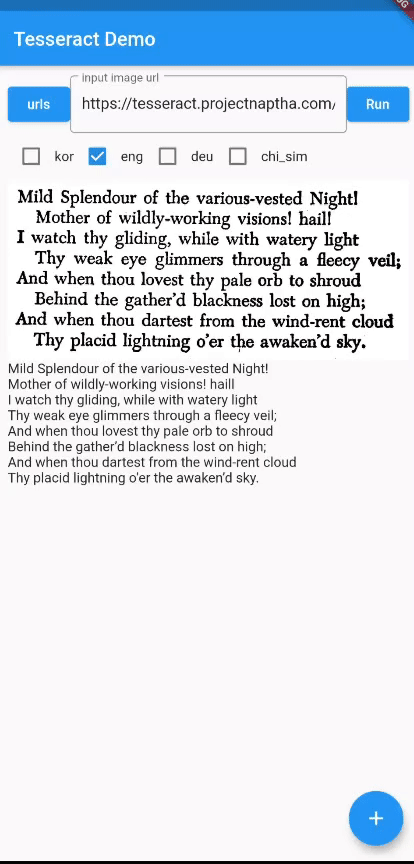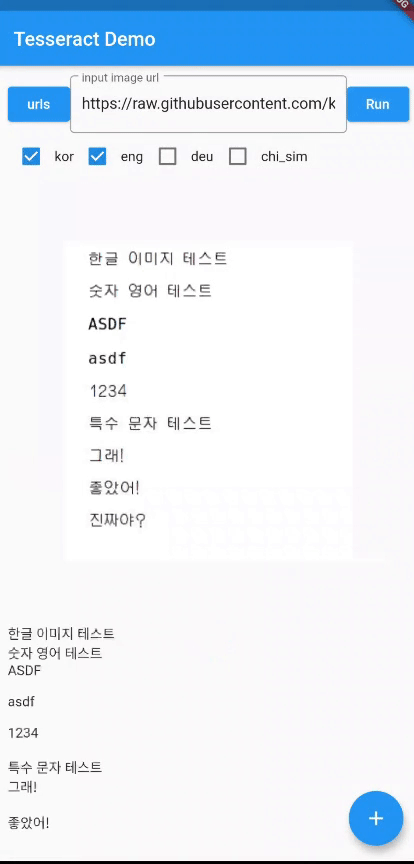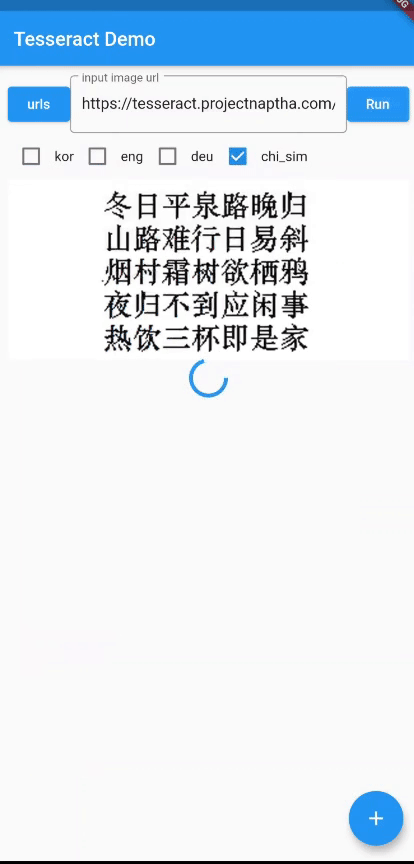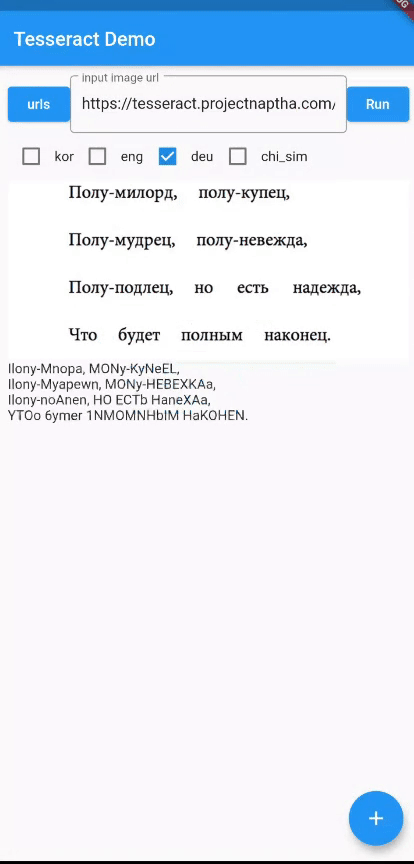
टेस्सेरैक्ट 4 एक नए न्यूरल नेटवर्क (LSTM) आधारित ओसीआर इंजन को जोड़ता है जो पंक्ति स्वीकृति पर केंद्रित है। इसमें यूनिकोड (UTF-8) समर्थन है, और इसमें 100 से अधिक भाषाओं की पहचान करने में सक्षम है।
सार्वजनिक जानकारी से बना चयन मार्गदर्शन। केवल संदर्भ हेतु।
Flutter Tesseract OCR एक Flutter प्लगइन है जो Tesseract 4 के उन्नत न्यूरल नेट (LSTM) आधारित OCR इंजन को एकीकृत करता है, जिससे 100 से अधिक भाषाओं में छवियों से सटीक पाठ पहचान संभव होती है। यह Unicode (UTF-8) का समर्थन करता है, जिससे बहुभाषी एप्लिकेशन के लिए आदर्श है। प्लगइन Android, iOS और Web प्लेटफॉर्म पर काम करता है, Flutter एप्लिकेशन में दस्तावेज़ स्कैनिंग और पाठ निकालने के लिए विकासकर्ताओं के लिए विश्वसनीय समाधान प्रदान करता है।
उपयोग
मोबाइल ऐप में दस्तावेज़ स्कैनिंग
चित्रों से पाठ निकालना
बहुभाषी पाठ स्वीकृति
स्वचालित फॉर्म डेटा कैप्चर
चित्र-आधारित खोज कार्यक्षमता
मुख्य विशेषताएँ
LSTM-आधारित OCR इंजन
100+ भाषाओं का समर्थन
यूनिकोड (UTF-8) पाठ आउटपुट
प्लेटफॉर्म के अनुकूलता
लाइन-स्तर स्वीकृति में उच्च सटीकता
इनके लिए उपयुक्त
OCR की आवश्यकता वाले मोबाइल ऐप्स
दस्तावेज प्रबंधन उपकरण
भाषा-अनुकूल टेक्स्ट निष्कर्ष
वेब और मोबाइल हाइब्रिड प्रोजेक्ट्स
छवि से पाठ कार्यप्रवाह वाले ऐप्स
विचार योग्य बातें
सर्वोत्तम परिणाम के लिए छवि पूर्वप्रसंस्करण की आवश्यकता होती है
कम क्षमता वाले उपकरणों पर प्रदर्शन में भिन्नता हो सकती है
गैर-मानक भाषाओं के लिए अतिरिक्त सेटअप की आवश्यकता है
बांडल्ड मॉडल्स के बिना सीमित ऑफ़लाइन समर्थन
मॉडल के आकार का एप्लिकेशन बंडल के आकार पर प्रभाव पड़ता है
मूल README
संबंधित सोर्स रिपॉज़िटरी के मूल README का स्नैपशॉट। नवीनतम सामग्री के लिए रिपॉज़िटरी देखें।
Tesseract OCR for Flutter
Fork note (onestudi0/tesseract_ocr): This fork exists solely to fix android/build.gradle,
which still declares the defunct jcenter() repository — current Gradle rejects the jcenter()
DSL method outright, so upstream fails to build at all as of this writing. This fork replaces it
with mavenCentral(). No other changes. If upstream (khjde1207/tesseract_ocr) ever merges an
equivalent fix, switch back to the pub.dev release and drop the dependency_overrides pointing
here.
You must add trained data and trained data config file to your assets directory.
You can find additional language trained data files here Trained language files
add tessdata folder under assets folder, add tessdata_config.json file under assets folder:
//args support android / Web , i don't have a macString text = awaitFlutterTesseractOcr.extractText('/path/to/image', language: 'kor+eng',
args: {
"psm": "4",
"preserve_interword_spaces": "1",
});
You can leave language empty, it will default to `'eng'.